Grundlagen verständlich · ← Wissen & Impulse
Offene Sprachmodelle auf eigenem Server. Was sie bei Belegen heute schaffen.
Müssen Bestellungen das Haus verlassen, damit eine KI sie lesen kann? Nicht unbedingt. Offene Sprachmodelle lassen sich auf eigenen Servern betreiben. Wir ordnen ein, was öffentliche Messungen über ihren Abstand zu den Spitzenmodellen sagen, was drei Studien an Rechnungen und Briefen zeigen und wie Sie an 100 eigenen Belegen prüfen, ob es für Ihren Fall reicht.

Das Wichtigste in Kürze
- Offene Spitzenmodelle lagen laut Epoch AI seit Januar 2026 im Schnitt rund vier Monate hinter den besten geschlossenen Modellen. Modelle für eine einzelne Consumer-Grafikkarte holen den Stand der Spitzenmodelle typischerweise erst nach sechs bis gut zwölf Monaten auf.
- In drei Studien an Geschäftsbelegen lasen offene Modelle mittlerer Größe die meisten Felder richtig. In den zwei Studien mit kleinen Modellen fielen diese deutlich ab. Ein Modell mit 14 Milliarden Parametern erreichte bei niederländischen Briefen einen F1-Wert von 95 Prozent, auf einem Laptop nur mit dem Prozessor gerechnet.
- Die Anweisung wiegt schwerer als die Stellschrauben: Beispiele in der Anweisung brachten in einer Studie bei einem Modell gut 19 Prozentpunkte, beim anderen rund 13. Das Ausgabeformat lässt sich erzwingen, die Richtigkeit nicht. Ob es für Ihre Bestellungen reicht, zeigt nur eine Messung an eigenen Belegen.
Müssen die Bestellungen das Haus verlassen?
Bei der Lindtaler Anlagenbau GmbH, einem erfundenen Betrieb, fragt der IT-Leiter das, was viele IT-Leiter fragen: Wenn eine KI unsere Bestellungen lesen soll, müssen die Mails dann zu einem Anbieter in die Cloud? Nicht unbedingt. Es kommt auf das Modell an, auf seine Größe und darauf, ob man nachmisst.
Öffentliche Ranglisten messen vieles. Eine Bestellung mit Zahlendreher in der Artikelnummer messen sie selten. Wir haben deshalb nach Studien gesucht, die Modelle an echten Aufgaben aus der Belegverarbeitung messen, und ordnen ein, was sie für Bestellungen bedeuten.
Offen heißt: Die Gewichte liegen bei Ihnen.
Ein offenes Sprachmodell ist eines, dessen Gewichte veröffentlicht sind. Man kann es herunterladen und auf einem eigenen Server betreiben, ohne dass Eingaben an den Hersteller des Modells gehen. Offen heißt aber nicht frei von Bedingungen. Mistral Small 3 und die dichten Qwen3-Modelle stehen laut Anbieter unter der Lizenz Apache 2.0, die kaum Pflichten mit sich bringt 56. Für Llama 4 gilt: Wer es weitergibt oder in einem bereitgestellten Produkt nutzt, muss sichtbar „Built with Llama“ angeben. Wer am Erscheinungstag von Llama 4 mehr als 700 Millionen monatlich aktive Nutzer hatte, braucht eine eigene Lizenz von Meta 7. Unternehmen mit Hauptsitz in der EU gewährt die Nutzungsrichtlinie für die multimodalen Llama-4-Modelle keine Rechte. Ausgenommen sind Endnutzer eines Produkts, das ein solches Modell enthält 7. Für Gemma bis Version 3 gilt eine Liste verbotener Nutzungen, und Google behält sich vor, die Nutzung bei Verstößen einzuschränken 8. Gemma 4 steht seit April 2026 laut Anbieter unter Apache 2.0 14.
Das ist unsere unverbindliche Lesart der Lizenztexte, keine Rechtsberatung. Nach unserer Einschätzung gehört die Lizenz deshalb vor die Frage, welches Modell am besten liest.
Der Abstand beträgt wenige Monate.
Das Forschungsinstitut Epoch AI vergleicht offene und geschlossene Modelle auf einem eigenen Gesamtmaß für Fähigkeiten. Seit Januar 2026 lagen die besten offenen Modelle demnach im Schnitt rund vier Monate hinter den besten geschlossenen 1. In einer früheren Auswertung vom Oktober 2025 nannte Epoch im Schnitt rund drei Monate 2. Beide Werte sind Durchschnitte über unterschiedliche Zeiträume. Einen Trend zeigen sie nicht, wohl aber die Größenordnung.
Für einen eigenen Server ist eine zweite Zahl wichtiger. Modelle, die auf einer einzelnen Consumer-Grafikkarte laufen, erreichen den Stand der Spitzenmodelle laut Epoch typischerweise nach sechs bis gut zwölf Monaten 3. Epoch weist selbst darauf hin, dass kleine Modelle auf bestimmte Testverfahren optimiert sein können und der Rückstand im Alltag größer sein kann 3. Wer ein kleines Modell betreibt, arbeitet also mit dem Stand von vor sechs bis gut zwölf Monaten, eher mehr als weniger. Für viele Aufgaben reicht das. Ob es für Belege reicht, sagen allgemeine Ranglisten nicht.
Wie weit offene Modelle zurückliegen
Drei Studien, ein Bild: Mittelgroß liest gut, klein fällt ab.
Forschende von Fraunhofer IAIS haben acht Modelle an Rechnungen getestet 4. Bei 350 gescannten Rechnungen mit je sieben Feldern erkannte das beste geschlossene Modell, Gemini 2.5 Pro, 92,7 Prozent der Felder richtig. Das offene Gemma 3 mit 12 Milliarden Parametern kam auf 82,1 Prozent, die kleinere Fassung mit 4 Milliarden auf 76,0 Prozent 4. Bei 500 sauberen, synthetisch erzeugten Rechnungen fiel das kleine Modell beim direkten Lesen des Bildes auf 45,7 Prozent. Wurde die Rechnung vorher in Text umgewandelt, kam es auf 84,6 Prozent 4. Alle diese Werte sind ohne Beispiele in der Anweisung gemessen 4. Die Autoren halten das mittelgroße Modell für eine brauchbare Alternative, vor allem mit Blick auf Kosten und Datenschutz 4.
Eine Studie aus den Niederlanden ging noch einen Schritt weiter in Richtung eigener Rechner 12. Die Forschenden erzeugten rund 1.000 erfundene niederländische Inkassobriefe und ließen ausschließlich lokale Modelle 200 davon auslesen, auf einem Laptop und nur mit dem Prozessor gerechnet. Ein Modell von DeepSeek mit 14 Milliarden Parametern erreichte im Schnitt einen F1-Wert von 95,2 Prozent, bei rund sechs Sekunden je Brief. Der F1-Wert verbindet, wie vollständig und wie genau ein Modell die Felder findet; kleine Lesefehler ließ die Studie dabei gelten. Gemma mit 4 Milliarden Parametern kam auf 78,9 Prozent, das winzige TinyLlama mit 1,1 Milliarden auf 15,9 Prozent 12. Ein Server ist ein Laptop nicht, aber die Größenordnung ist klar: Für das Auslesen solcher Belege braucht es nicht zwingend ein Rechenzentrum.
Die dritte Studie verglich an 2.400 synthetischen spanischen Stromrechnungen mit rund 60 Feldern je Rechnung Gemini 1.5 Pro mit Mistral Small, laut Studie einem dichten Modell mit 24 Milliarden Parametern 13. Welche Fassung genutzt wurde, nennt die Studie nicht. Mistral hat Modelle dieser Größe offen veröffentlicht, etwa Mistral Small 3 unter Apache 2.0 5. In der besten Einstellung lagen beide nah beieinander, mit F1-Werten von 97,6 und 96,1 Prozent 13. Genutzt wurden beide über die Schnittstelle des Herstellers, nicht auf einem eigenen Server.
Die drei Studien sind untereinander nicht vergleichbar. Sie messen verschiedene Belege mit verschiedenen Maßen, und sie messen weder deutsche Belege noch Bestellungen. Das Bild ist trotzdem eindeutig: Ab mittlerer Größe liest ein offenes Modell in allen drei Studien die meisten Felder richtig. Wo kleinere Modelle mitgetestet wurden, wurde es schnell dünn.
Was drei Studien an Belegen zeigen
offenes Modellgeschlossenes Modell
Die Anweisung wiegt schwerer als die Stellschrauben.
Die spanische Studie zeigt außerdem etwas, das für jeden Betrieb nützlich ist. Zwischen einer Anweisung ohne Beispiele und der besten Anweisung mit Beispielen lagen bei Gemini mehr als 19 Prozentpunkte, bei Mistral rund 13 13. Die besten Werte stammen aus Tests an Rechnungsvorlagen, aus denen keine Beispiele kamen. Der Abstand ist deshalb eine Größenordnung, kein exakter Effekt. Bei Gemini änderten technische Einstellungen wie die Temperatur dagegen kaum etwas: Über 19 Einstellungen schwankte der F1-Wert um gut einen halben Punkt 13. Wer also ein Modell bewertet, sollte zuerst die Anweisung ernst nehmen und dann über das Modell urteilen.
Zudem fiel ein Muster auf, das bei Bestellungen teuer werden kann. Mistral gab mit Beispielen fast zu jedem Feld einen Wert aus, lag dabei aber öfter falsch. Die Autoren deuten das so, dass das Modell öfter Werte ausgibt, wo im Beleg gar keine stehen 13. Ein erfundener Liefertermin sieht im Datensatz genauso ordentlich aus wie ein echter.
Werkzeuge wie vLLM können ein Modell laut Projektdokumentation auf ein festes Antwortschema festlegen 10. Damit kommt aus jedem Beleg ein Datensatz im vorgegebenen Format. Ob die Artikelnummer darin stimmt, erzwingt das Schema nicht. Auch die Selbsteinschätzung der Modelle hilft nur begrenzt. In einer Studie mit Modellen von 2023 neigten Sprachmodelle dazu, sich zu überschätzen, wenn sie ihre Sicherheit selbst angaben 11. Deshalb gehören hinter jedes Modell feste Prüfregeln, und zwar unabhängig davon, wo es läuft.
Warum der eigene Server mehr ist als Geschmack.
Die Datenschutzkonferenz von Bund und Ländern unterscheidet technisch geschlossene Systeme von offenen, bei denen Eingaben den geschützten Bereich der Anwender verlassen. Technisch geschlossene Systeme hält sie aus Datenschutzsicht für vorzugswürdig 9. Kennzeichen eines geschlossenen Systems sind laut DSK ein eng begrenzter Anwenderkreis, die Kontrolle der Anwender über Ein- und Ausgabedaten und dass der Anbieter die Eingaben nicht zum Training nutzt. Mit offenen Gewichten hat das nichts zu tun. Ein offenes Modell auf einem selbst kontrollierten Server ist eine Möglichkeit, eine solche Umgebung zu schaffen. Das ist unsere unverbindliche Einschätzung, keine Rechtsberatung.
So prüfen Sie es: 100 eigene Belege, zwei Wege, fünf Messgrößen.
Keine der Studien hat Ihre Bestellungen gesehen. Eine kleine eigene Messung schließt diese Lücke. Nehmen Sie 100 Belege, anonymisiert oder den echten nachgebaut, und zwar in der Mischung, in der sie bei Ihnen ankommen: Mails, PDF-Anhänge, Scans. Nehmen Sie die Ausnahmen bewusst mit, also Zahlendreher in Artikelnummern, fehlende Liefertermine, abweichende Preise und mehrere Positionen in einer Mail. Was richtig ist, legt vorher ein Mensch fest.
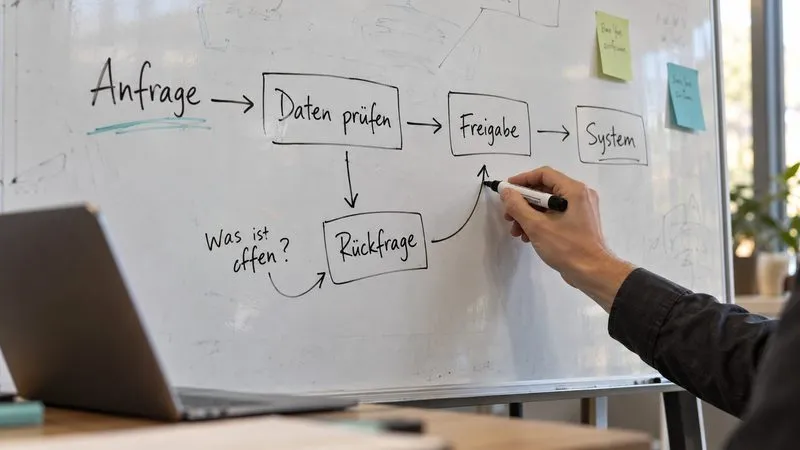
Weg A ist ein offenes Modell auf einem eigenen Server, Weg B ein Spitzenmodell über das Internet. Beide bekommen dieselben Belege, dieselbe Anweisung mit einigen Beispielen und dasselbe Ausgabeformat. Danach laufen dieselben Prüfregeln: Gibt es die Artikelnummer? Passt der Preis zur Preisliste? Ist die Menge plausibel? Was durchfällt, geht an einen Menschen. Das ist unser Ordnungsmodell: KI versteht, Regeln prüfen, Menschen entscheiden.
Zählen Sie fünf Dinge: richtig erkannte Felder, Belege ganz ohne Fehler, den Anteil, den die Regeln an einen Menschen geben, die Laufzeit je Beleg und, am wichtigsten, falsche Felder, die alle Regeln bestehen. Diese Fehler fallen im Alltag niemandem auf.
So prüfen Sie es an 100 eigenen Belegen
Was offen bleibt
Alle drei Studien arbeiten mit Datensätzen, die nicht aus deutschen Betrieben stammen, zwei davon ausschließlich mit erfundenen Belegen, die dritte teilweise. Eine öffentliche Messung an deutschen Bestellungen haben wir nicht gefunden. Eigene Messwerte enthält dieser Beitrag nicht. Wenn wir messen, ergänzen wir sie hier mit Datum. Modelle wechseln schnell: Was heute auf einer Grafikkarte läuft, ist in einem Jahr überholt. Betriebskosten nennen wir bewusst nicht, weil sie stark von Menge und Hardware abhängen.
Unsere Empfehlung
Prüfen Sie zuerst die Lizenz, dann die Größe. In den beiden Studien, die auch kleine Modelle testeten, fielen diese deutlich ab. Planen Sie deshalb mindestens ein mittelgroßes Modell ein. Bevor Sie zwischen eigenem Server und einem Anbieter über das Internet entscheiden, messen Sie beide Wege an 100 eigenen, anonymisierten Belegen, mit derselben Anweisung samt Beispielen und denselben Prüfregeln. Am wichtigsten ist dabei der Anteil falscher Felder, die trotz aller Prüfregeln durchrutschen.
Baut Lösungen so, dass sie sicher, nachvollziehbar und zuverlässig laufen.
Das Team kennenlernen →Hinweis: Unsere Beiträge geben die unverbindliche Einschätzung von Omnerio wieder. Sie sind keine Rechts-, Steuer- oder sonstige Beratung und ersetzen keine Prüfung im Einzelfall.
Quellen
- 1Epoch AI, Edwards, Emberson: „Open models lag state-of-the-art closed models by 4 months“, Data Insight vom 29.05.2026. Abstand auf dem Epoch Capabilities Index (ECI). epoch.ai · zuletzt geprüft am 18.10.2026
- 2Epoch AI, Emberson: „Open-weight models lag state-of-the-art by around 3 months on average“, Data Insight vom 30.10.2025. epoch.ai · zuletzt geprüft am 18.10.2026
- 3Epoch AI, Somala, Emberson: „Frontier AI performance becomes accessible on consumer hardware within a year“, Data Insight vom 15.08.2025, Daten aktualisiert 18.11.2025. Modelle, die auf einer einzelnen RTX 4090 oder 5090 laufen. epoch.ai · zuletzt geprüft am 18.10.2026
- 4Berghaus, Berger, Hillebrand, Cvejoski, Sifa (Fraunhofer IAIS, Lamarr-Institut): Multi-Modal Vision vs. Text-Based Parsing: Benchmarking LLM Strategies for Invoice Processing. arXiv 2509.04469v1, 29.08.2025; Tabelle I; 350 gescannte Rechnungen mit je sieben Feldern; 500 synthetische, digital erzeugte Rechnungen. Sprache der Datensätze im Paper nicht angegeben, nach unserer Kenntnis englisch. arxiv.org · zuletzt geprüft am 18.10.2026
- 5Mistral AI: Mistral Small 3, 30.01.2025 (24 Milliarden Parameter, Lizenz Apache 2.0). Angaben laut Anbieter. mistral.ai · zuletzt geprüft am 18.10.2026
- 6Qwen Team: Qwen3, 29.04.2025 (Lizenz Apache 2.0 für die Dense-Modelle). Angaben laut Anbieter. qwenlm.github.io · zuletzt geprüft am 18.10.2026
- 7Meta: Llama 4 Community License Agreement, gültig ab 05.04.2025, Abschnitte 1.b.i und 2, sowie Llama 4 Acceptable Use Policy (Abschnitt zu multimodalen Modellen und Unternehmen mit Hauptsitz in der EU, mit Ausnahme für Endnutzer). dev.meta.ai · zuletzt geprüft am 18.10.2026
- 8Google: Gemma Terms of Use, zuletzt geändert am 01.04.2026, Abschnitt 3.2. ai.google.dev · zuletzt geprüft am 18.10.2026
- 9Datenschutzkonferenz (DSK): Orientierungshilfe „Künstliche Intelligenz und Datenschutz“, Version 1.0, 06.05.2024, Ziffer 1.7. datenschutzkonferenz-online.de · zuletzt geprüft am 18.10.2026
- 10vLLM-Dokumentation: Structured Outputs. Angaben laut Projekt. docs.vllm.ai · zuletzt geprüft am 18.10.2026
- 11Xiong u. a.: Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs. ICLR 2024, arXiv 2306.13063v2, 17.03.2024. arxiv.org · zuletzt geprüft am 18.10.2026
- 12Celep, Amat-Lefort, Visser: Privacy-Preserving Information Extraction with Local LLMs: A Comparative Study on Dutch Debt Collection Letters. LREC 2026, S. 10140–10149, Mai 2026; Tabellen 3 und 4, Abschnitte 3.4 und 3.5. rund 1.000 synthetische niederländische Inkassobriefe, davon 200 als Testmenge; F1 mit exaktem und unscharfem Abgleich; quantisierte Modelle über llama.cpp, nur Prozessor, MacBook Pro mit Apple M1 Max und 32 GB Arbeitsspeicher. aclanthology.org · zuletzt geprüft am 19.10.2026
- 13Gómez, Sánchez: Information Extraction from Electricity Invoices with General-Purpose Large Language Models. arXiv 2604.25927v1, 01.04.2026; Zusammenfassung sowie Tabellen 7 und 8. 2.400 synthetische spanische Stromrechnungen aus dem Datensatz IDSEM, rund 60 Felder je Rechnung; beide Modelle über die Schnittstellen der Hersteller, ohne Nachtraining; Mistral-Version im Paper nicht angegeben (dichtes Modell mit 24 Milliarden Parametern). Parameteranalyse nur mit Gemini; Ergebnisse der Strategien mit Beispielen ohne die Vorlagen, aus denen die Beispiele stammen. arxiv.org · zuletzt geprüft am 19.10.2026
- 14Google: Gemma 4: Expanding the Gemmaverse with Apache 2.0, Google Open Source Blog vom 02.04.2026. Angaben laut Anbieter. opensource.googleblog.com · zuletzt geprüft am 10.11.2026
Titelbild: eigenes Symbolbild, mit KI erstellt.
Passend dazu
Sie möchten das Thema auf Ihren Betrieb übertragen? Nennen Sie uns den Beitrag und beschreiben Sie kurz Ihren Ablauf.
Gespräch vereinbaren